
İnterneti sayan yazı atma hilesi
Her yerde kullanılan HyperLogLog algoritması nasıl çalışır?
Diyelim ki Scientific American web sitesindeki makalelerimden birini kaç kişinin okuduğunu bilmek istiyorum. Makalenin kaç kez açıldığını saymak kolaydır: Web sitesi sürekli güncellenen bir sayacı tutabilir ve her sayfa yüklendiğinde bu sayacı bir artırabilir. Bu sayacı tek bir sayıdır ve depolamak için çok az bellek gerektirir. Ancak sayfa yüklemeleri insanlar değildir. Belki de makaleyi kahvaltı sırasında okumaya başladınız, sonra dikkatiniz dağıldı ve öğle yemeğinden sonra bitirmek için geri döndünüz. Basit bir sayım sizi iki kez sayardı. Benzersiz kullanıcıları doğru bir şekilde saymak için web sitesinin her okuyucuyu kaydetmesi ve sayfayı yükleyen her okuyucuyu bu listede kontrol etmesi gerekir. Toplam görüntülenmeyi saymak tek bir sayı gerektirirken, benzersiz kullanıcıları saymak, kitle kadar büyük bir kimlik listesine ihtiyaç duyuyor gibi görünüyor. Şimdi bir makaleyi açan kimlik sayısını her makaleyle, bir sosyal medya platformundaki her gönderiyle (belki de eğilimleri ölçmek için) veya bir web sitesindeki her reklamla (reklamverenlerin kotalarını karşılamak için) çarpın; her birinin potansiyel olarak milyonlarca kimlik içeren kendi listesi vardır. Bu listeler, basit bir soruyu yanıtlamak için devasa veri dağlarına dönüşür: “Bunu kaç kişi gördü?”

İşte burada HyperLogLog algoritması devreye giriyor. Tam sayımlar yerine yakın tahminlerle yetinir ve karşılığında tam kimlik listelerinin gerektirdiği belleğin yalnızca küçük bir kısmını kullanır. Bu algoritmayı öğrenmek en az iki nedenle değerlidir. Birincisi, her yerde kullanılmaktadır. Neredeyse tüm web sitelerinin yarısındaki trafiği takip eden Google Analytics, ziyaretçi metriklerini tahmin etmek için geliştirilmiş bir versiyonuna dayanır. Kişisel bir blogunuzun ziyaretçi sayısını kontrol ettiyseniz, muhtemelen onun eserini görmüşsünüzdür. Google’ın ötesinde, genomik ve siber güvenlik de dahil olmak üzere birçok alan da buna bağımlıdır. İkincisi, HyperLogLog inanılmaz derecede zariftir.
Algoritmanın temel fikrini anlamak için bir oyunla başlayalım. Yazı gelene kadar sürekli olarak bir yazı-tura atacağım ve ardından yazı gelmeden önce kaç tane tura geldiğini not edeceğim. Bu bir tur olarak sayılacaktır. Bu işlemi birçok tur boyunca tekrarlayacağım ve yalnızca tek bir sayıyı takip edeceğim: yazının ilk kez gelmesinden önceki en uzun tura serisi. Şimdi diyelim ki bir öğleden sonra yazı atma deneyimimden sonra kaydımın art arda 10 tura olduğunu söylüyorum. Göreviniz, kaç tur oynadığımı tahmin etmektir.
İyi bir tahmin yapabilirsiniz. 10 tura serisi yaklaşık olarak her 1.000 turda bir ortaya çıkar. Bunun nedeni, tek bir atışta yazı gelme olasılığının 1⁄2 olmasıdır. İlk atışın tura gelme olasılığı 1⁄2; ilk iki atışın da tura gelme olasılığı 1⁄4; ilk üç atışın da tura gelme olasılığı 1⁄8 ve bu şekilde devam eder; payda, 10 ardışık tura bir turda ortaya çıkana kadar iki katına çıkar. Sadece bir düzine tur oynamış olsaydım, bu kadar uzun bir seri şaşırtıcı bir tesadüf olurdu. Bir milyon tur oynamış olsaydım, neredeyse kesinlikle daha uzun bir seri görmüş olurdum. Kaydım 1.000’de bir olasılıkla gerçekleşen bir olaydı, bu yüzden iyi bir tahmin, bunun yaklaşık 1.000 tur sürdüğüdür.
HyperLogLog da aynı oyunu oynar, ancak her tur bir ziyaretçiye karşılık gelir. Yüksek düzeyde, her ziyaretçinin bir dizi yazı-tura attığını, sonuçları yazdığını ve her ziyaretinde bunları siteye gösterdiğini hayal edin. Tıpkı en uzun tura serimi bilmenin toplam tur sayısını tahmin etmenize olanak sağlaması gibi, site de kitle boyutunu tahmin etmek için tüm ziyaretçileri arasındaki en uzun tura serisini takip etmesi yeterlidir.
Diyelim ki 10 kişi ziyaret ediyor. İki kişinin yazı-tura dizileri TTTH ile başlarken, diğer sekiz kişinin dizileri H, TH veya TTH ile başlıyor. Site sadece gördüğü en uzun başlangıç serisi olan üçü hatırlar. Bu, kabaca bir tahmin için yeterlidir: 23, yani yaklaşık sekiz ziyaretçi — gerçek sayı olan 10’dan çok da uzak değil. Daha sonra biri daha uzun bir seriyle gelirse, rekor yükselir. Ve ilk 10 kişiden biri geri dönerse, sitenin onun tekrar gelen bir ziyaretçi olup olmadığını bilmesine gerek yoktur: Aynı atış dizisini getirir, bu yüzden tahmini ziyaretçi sayısı değişmez.
Sitenin ne kadar az şey hatırlaması gerektiğine dikkat edin. 1.000 kişilik bir kitle büyük olasılıkla en uzun serisini yaklaşık 10 turdan sonra üretir. Bir milyon kişinin yaklaşık 20 turda bir rekor bir seriye sahip olması beklenir. Bir milyardan sonra bu sayı 30’a yükselir. Dünyadaki her insan ziyaret etse bile, rekor seri muhtemelen 30’ların başında bir yerde ortaya çıkardı. Benzersiz ziyaretçileri tam olarak saymak için milyarlarca kimliği depolamaktan, tahmin için yalnızca iki basamaklı bir sayı depolamaya geçtik.
İki önemli soru hala var: Her ziyaretçinin yazı atmasını ve bunları hatırlamasını nasıl sağlarız? Peki ya biri alışılmadık derecede uzun bir tura serisi elde edip tahmini bozarsa?
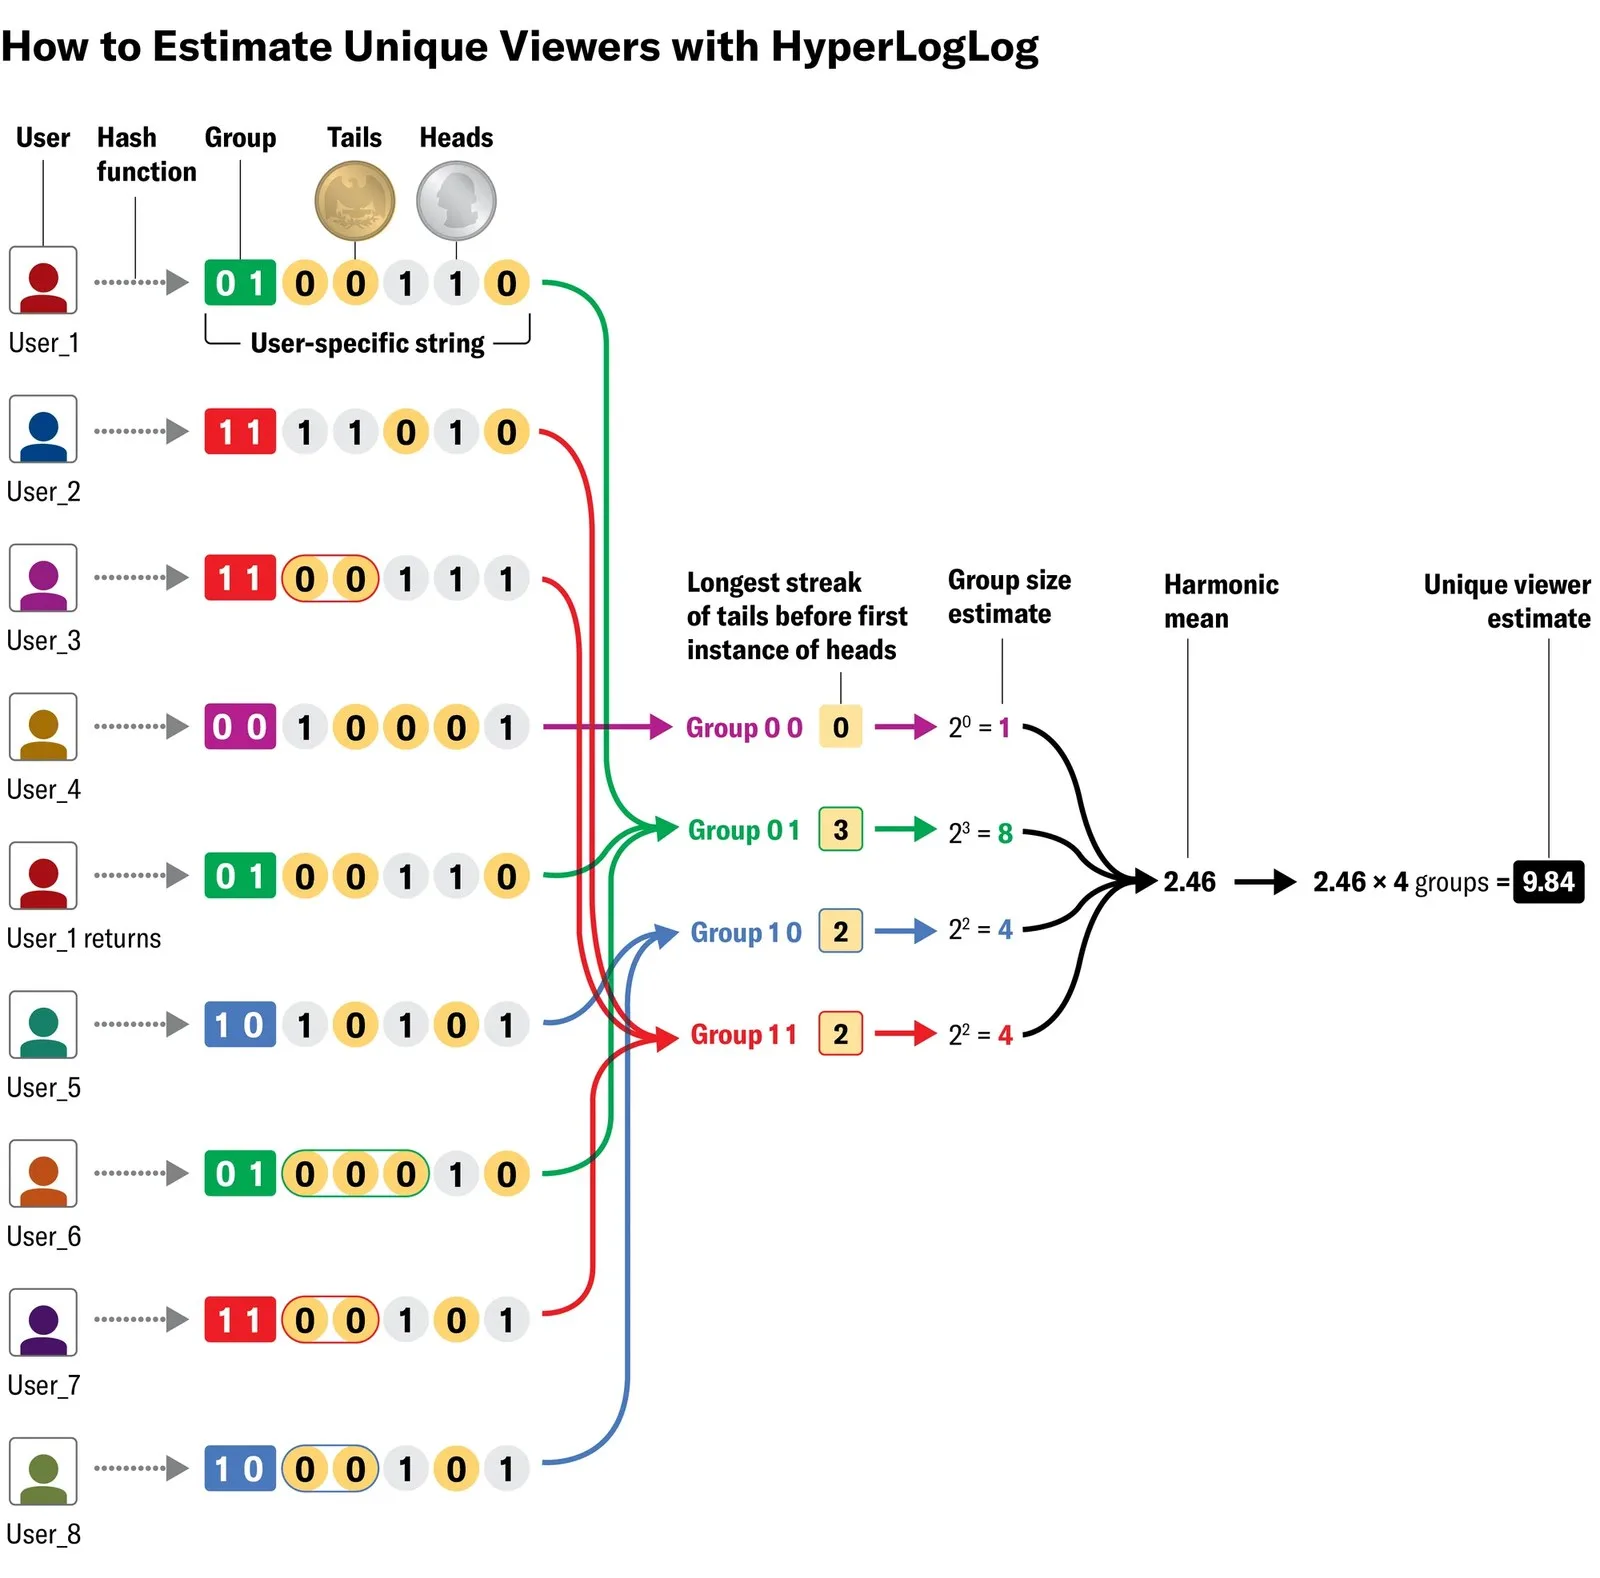
İlk olarak, elbette ziyaretçiler gerçekten yazı atmazlar; tura ve yazı yerine, HyperLogLog algoritması 0’ları ve 1’leri takip eder. İşte nasıl çalıştığı: Bir web sitesini ziyaret ettiğinizde, algoritma benzersiz kimliğinizi alır ve bir hash fonksiyonundan geçirir. Hash fonksiyonları bilgisayar bilimlerinde her yerdedir. Bir girdi alırlar ve tamamen deterministik olmasına rağmen rastgele görünen bir çıktıya dönüştürürler. Bu, bir hash fonksiyonunun çıktılarının rastgele sayılar gibi ele alınabileceği, ancak aslında fonksiyonun aynı girdi verildiğinde her zaman aynı çıktıyı üreteceği anlamına gelir. Yani bir hash fonksiyonu sizden kullanıcı_8675309 gibi bir kullanıcı adını okur ve bunu 01100101000100101000 gibi 1’ler ve 0’lardan oluşan bir dizeye dönüştürür. Bu bitler rastgele yazı-tura atışları olarak ele alınır; 0 tura, 1 ise yazıya karşılık gelir. Kimliğinizi kullanarak siteyi bir sonraki ziyaretinizde, aynı hash fonksiyonu sizi tanımlamak için aynı bit dizisini üretir.
İkinci olarak, bazen beklenmedik durumlar olur. Birinin hash fonksiyonu çıktısı nesiller boyu tura atmakla eşdeğerse, site kitlesini aşırı derecede fazla tahmin edecektir. Bu tür beklenmedik durumlara karşı korunmak için algoritma, kitleyi birçok gruba ayırır, her grubun boyutunu bağımsız olarak tahmin eder, bu tahminlerin ortalamasını alır ve sonuçları birleştirir.
HyperLogLog, her kişinin dizisindeki ilk birkaç “atışı” akıllıca bir grup ataması için kullanır. Diyelim ki dört grup istiyoruz. Dizileri 11 ile başlayan ziyaretçiler bir gruba, 10 ile başlayanlar başka bir gruba girer; 01 ve 00 için de aynı durum geçerlidir. Site daha sonra bu ilk iki atışı kenara ayırır ve her grup içinde, sonraki basamakların başlangıcındaki en uzun tura serisini takip eder. Örneğin, dizisi 10001 ile başlayan bir ziyaretçi, 10 grubuna iki turluk bir seriyle katılır; eğer bu, 10 grubundaki herhangi birinin gösterdiği en uzun seri ise, sitenin o grup için kaydı basitçe iki olur. İlk iki atış insanları eşit şekilde ayırdığı için, her grup dinleyicilerin yaklaşık dörtte birini içermelidir; dolayısıyla her grubun kaydı, toplamın dörtte birine ilişkin kendi tahminini verir. Bu dört tahmini ortalamak ve dörde çarpmak, tüm dinleyici kitlesinin bir tahminini verir. Bu şekilde, tek bir şanssız ziyaretçi dört kayıttan yalnızca birini bozabilir ve diğer üçü ortalamayı gerçeğe geri çeker. Gerçek uygulamalar binlerce grup ve istatistiksel aykırı değerlerin ağırlığını azaltan harmonik ortalama adı verilen özel bir ortalama türü kullanır; böylece tek bir istisna neredeyse hiç etkilemez. Sonuç olarak, HyperLogLog tahminleri genellikle yüzde 1’den daha az sapma gösterir. Bu hata payının karşılığında, siteler bu makaleyi saklamak için gereken bellek miktarıyla milyarlarca benzersiz kullanıcıyı sayabilir.
Benzersiz ziyaretçileri tahmin etmenin ötesinde, bu algoritma hem siber güvenlik uzmanlarının bot sürüleri gibi anormal web faaliyetlerini tespit etmesine hem de biyologların genomlar arasında benzerlikler bulmasına yardımcı olur. Devasa bir veri setindeki farklı öğeleri tahmin etmek isteyen herkes için HyperLogLog muhtemelen sayımı yapmaktadır.
Scientific American Baş Editörü
Bu gelişme hakkında düşüncelerinizi, donanım deneyimlerinizi veya sorularınızı Topluluk Forumumuzda paylaşın.
Foruma Katıl & Yanıtla ➔


1 yorum
Fikrinizi bir kaynak, soru veya yapıcı karşı görüşle geliştirin.